Maand: september 2026

Ontwikkelaar werkt op laptop met code tijdens optimalisatie van een website

Core Web Vitals optimaliseren: het concrete stappenplan voor snellere laadtijden en stabiele pagina’s

Waarom webprestaties de directe brug slaan tussen techniek en omzet

Een website kan technisch correct functioneren en toch omzet verliezen. Bezoekers ervaren geen serverarchitectuur, JavaScript-framework of contentmanagementsysteem. Ze ervaren vooral hoe snel de belangrijkste inhoud verschijnt, hoe vlot een klik wordt verwerkt en of de pagina stabiel blijft terwijl ze lezen of kopen. WPO Stats bundelt praktijkonderzoek waarin verbeteringen in webprestaties samenhangen met hogere conversie, minder bounces, meer betrokkenheid en betere omzetresultaten.

Daar ontstaat vaak een organisatorisch probleem. Directies spreken over omzet, klanttevredenheid en rendement, terwijl developmentteams praten over threads, render blocking resources en lange JavaScript-taken. Core Web Vitals vormen de vertaling tussen beide werelden. De bredere context van web performance wordt ook helder beschreven op Wikipedia. Deze gids geeft een nuchter stappenplan voor LCP, INP en CLS, gebaseerd op echte gebruikersdata en gekoppeld aan beslissingen die product, marketing en development samen kunnen nemen.

De drie Core Web Vitals en hun harde drempelwaarden

Core Web Vitals meten drie verschillende onderdelen van de gebruikerservaring. Largest Contentful Paint, of LCP, laat zien hoe snel het grootste zichtbare inhoudselement verschijnt. Dat element is vaak een hero-afbeelding, productafbeelding, koptekstblok of video. LCP wordt beïnvloed door serverresponstijd, netwerkvertraging, prioriteit van resources en de manier waarop de browser de pagina opbouwt.

Interaction to Next Paint, kortweg INP, meet hoe snel de pagina reageert nadat een bezoeker klikt, tikt of een toets gebruikt. Anders dan de voormalige First Input Delay kijkt INP naar interacties gedurende de hele sessie. Cumulative Layout Shift, of CLS, meet vervolgens hoeveel onverwachte verschuivingen in de layout plaatsvinden. Een knop die tijdens het laden opschuift, kan bijvoorbeeld leiden tot een verkeerde klik en een direct slechtere gebruikerservaring.

Google beoordeelt de metrics doorgaans op het 75e percentiel, afzonderlijk voor mobiele en desktopgebruikers. Dat betekent dat niet alleen de snelste bezoekers tellen. Een pagina moet een brede groep echte bezoekers een goede ervaring bieden. De officiële definities en actuele richtlijnen staan in het overzicht van Web Vitals.

Metric Goed Verbetering nodig Slecht
LCP 2,5 seconden of minder Meer dan 2,5 tot en met 4 seconden Meer dan 4 seconden
INP 200 milliseconden of minder Meer dan 200 tot en met 500 milliseconden Meer dan 500 milliseconden
CLS 0,1 of minder Meer dan 0,1 tot en met 0,25 Meer dan 0,25

Zo pak je het aan met een pragmatisch vierstappenplan

Een effectieve aanpak begint niet met het willekeurig verkleinen van JavaScript of het vervangen van een framework. Eerst moet duidelijk zijn welke bezoekers, templates en interacties het probleem veroorzaken. Daarna volgt een gerichte interventie, met een nieuwe meting en een koppeling aan een zakelijke KPI.

  1. Begin met velddata. Gebruik het Core Web Vitals-rapport in Google Search Console en raadpleeg het Chrome User Experience Report, ook bekend als CrUX. Deze bronnen laten zien hoe echte gebruikers de website ervaren, verdeeld naar apparaat, URL en soms verbindingstype. Eigen Real User Monitoring is nog waardevoller, omdat daarmee ook conversie, land, browser, ingelogde status en specifieke componenten kunnen worden gekoppeld. Labtests zoals Lighthouse zijn nuttig voor diagnose, maar vervangen velddata niet.
  2. Verkort LCP via de kritieke route. Onderzoek eerst de Time to First Byte, omdat een trage server of ongunstige caching de hele pagina vertraagt. Controleer daarna of het belangrijkste hero-element te laat wordt ontdekt, onnodig groot is of als achtergrondafbeelding wordt geladen. Geef de LCP-resource de juiste prioriteit, gebruik moderne afbeeldingsformaten, beperk render-blocking CSS en voorkom dat een groot framework eerst moet initialiseren voordat de hoofdcontent zichtbaar wordt. Een CDN, server-side rendering en goede edge-caching kunnen helpen, maar alleen wanneer de configuratie aansluit op de daadwerkelijke bezoekersstromen.
  3. Verlaag INP door de main thread vrij te maken. INP bestaat uit input delay, verwerkingstijd en de tijd tot de volgende visuele weergave. Zoek in RUM naar de concrete interactie die traag is, bijvoorbeeld een filter, zoekveld, winkelmandje of menu. Reproduceer die interactie vervolgens in Chrome DevTools. Knip lange taken op, geef de browser tussendoor ruimte met yield-patronen en verplaats niet-essentieel werk naar na de eerste visuele update. De praktische richtlijnen van web.dev over INP optimaliseren benadrukken daarnaast het beperken van DOM-mutaties, layout thrashing en zware scripts van derden.
  4. Elimineer onverwachte layoutverschuivingen. Reserveer vooraf ruimte voor afbeeldingen, video”s, embeds, iframes en advertenties door breedte- en hoogtegegevens of een passende aspect-ratio vast te leggen. Controleer ook dynamische banners, cookiepanelen en gepersonaliseerde aanbevelingen. Webfonts vragen extra aandacht: kies een goede fallback, gebruik passende font-display-instellingen en controleer of een late fontwissel tekstblokken zichtbaar laat verspringen. Test vooral pagina”s met meerdere componenten, omdat kleine verschuivingen zich daar kunnen opstapelen.

Maak per stap één eigenaar en één acceptatiecriterium. Een product owner kan bijvoorbeeld bepalen dat de productdetailpagina prioriteit krijgt, marketing kan de conversie-impact volgen en development kan vastleggen dat 75 procent van mobiele sessies onder de relevante drempel blijft. Zo wordt optimalisatie een beslisbaar werkpakket in plaats van een eindeloze technische discussie.

Valkuilen die optimalisaties in de praktijk ondermijnen

Veel teams verbeteren een Lighthouse-score op een ontwikkelmachine en verwachten daarna automatisch betere resultaten in Search Console. Dat werkt niet altijd. Labdata gebruikt een gesimuleerde omgeving, terwijl velddata rekening houdt met oudere telefoons, wisselende verbindingen, geografische spreiding en echt gebruikersgedrag. Een pagina kan in de testomgeving snel lijken en op een mobiel netwerk alsnog een slechte LCP of INP hebben.

  • Blind vertrouwen op één labtest. Gebruik Lighthouse voor hypotheses en regressietests, maar baseer prioriteiten op RUM, CrUX en Search Console.
  • Te veel scripts van derden. Tag managers, advertentieplatforms, chatwidgets en trackingpixels kunnen CPU-tijd gebruiken en de main thread blokkeren. Meet elk script afzonderlijk en stel de vraag of de zakelijke waarde opweegt tegen de prestatiekosten.
  • Webfonts zonder fallbackstrategie. Een font dat laat arriveert of een tekstblok opnieuw laat opmaken, kan zowel de leesbaarheid als CLS verslechteren.
  • Eenmalige optimalisatie. Een nieuwe campagne, component, leverancier of trackingtag kan prestaties opnieuw aantasten. Zonder budget voor monitoring en regressietests verdwijnt het resultaat meestal geleidelijk.

Een extra risico is optimaliseren zonder segmentatie. Een gemiddelde score kan verhullen dat iPhone-gebruikers goed presteren, terwijl Android-bezoekers op trage verbindingen afhaken. Splits daarom minimaal uit naar mobiel en desktop, en bij grote volumes ook naar template, land, browser en ingelogde versus uitgelogde bezoekers.

De meetbare opbrengst en concrete monitoring KPI’s

Wat levert het op? Snellere en stabielere pagina”s kunnen de kans vergroten dat bezoekers verder klikken, formulieren invullen en een bestelling afronden. De relatie is niet overal lineair en een betere Core Web Vitals-score garandeert geen hogere omzet. Productaanbod, prijs, vertrouwen en gebruiksgemak blijven bepalend. Toch laten praktijkcases zien dat prestaties een beïnvloedbare factor zijn binnen de totale conversieketen.

Rakuten 24 koppelde veldmetingen aan een interne analyticsomgeving en voerde een A/B-test uit. De geoptimaliseerde landingspagina laadde 0,4 seconde sneller, verbeterde CLS met 92,72 procent en ging samen met 53,37 procent hogere omzet per bezoeker, 33,13 procent hogere conversie en 15,20 procent hogere gemiddelde orderwaarde. Zulke cijfers zijn geen universele benchmark, maar ze tonen wel hoe technische verbeteringen zakelijk toetsbaar worden wanneer de meetopzet zorgvuldig is. Zie voor de volledige case het Rakuten 24-onderzoek.

  • Core Web Vitals: het percentage mobiele en desktopbezoeken met goede LCP, INP en CLS.
  • Business per segment: conversieratio, omzet per bezoeker, orderwaarde en checkout-voltooiing per prestatiecategorie.
  • Gedrag: bounce rate, exit rate, sessieduur, pagina”s per sessie en interactiediepte.
  • Technische oorzaken: TTFB, JavaScript-tijd, long tasks, omvang van de DOM en aandeel scripts van derden.
  • Regressies: het aantal releases per maand waarbij een template of component buiten de afgesproken drempel komt.

Combineer deze KPI”s in één dashboard. Toon niet alleen een totaalscore, maar ook trends, segmenten en de belangrijkste URL-groepen. Stel per metric een waarschuwing in voordat de officiële grens wordt overschreden, zodat het team kan ingrijpen voordat een probleem zichtbaar wordt in rapportages of omzet.
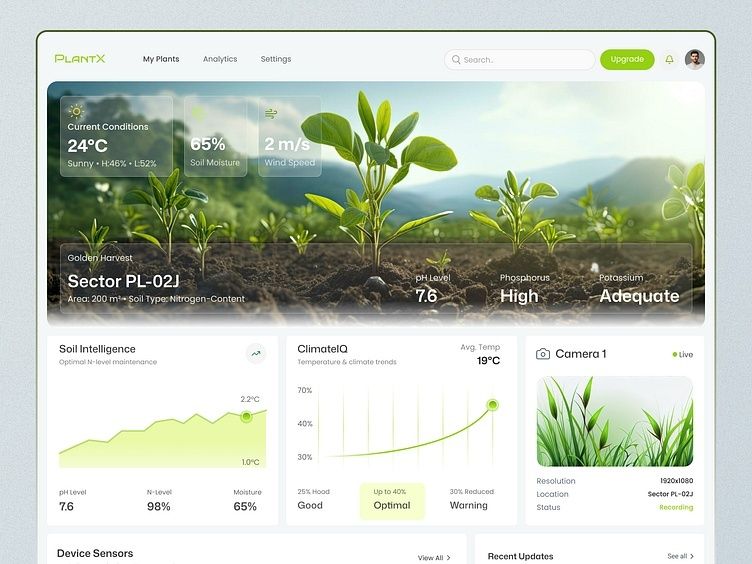
Dashboard met plantmetingen, grafieken en een live camerabeeld
Een centraal prestatiedashboard brengt technische signalen en zakelijke resultaten samen, zodat teams sneller kunnen bijsturen voordat prestatieproblemen omzet kosten.

Maak webprestaties een vast onderdeel van het ontwikkelproces

Core Web Vitals zijn geen eenmalig vinkje in een SEO-audit. Ze zijn een kwaliteitsstandaard die verandert zodra content, functionaliteit, campagnes of externe scripts veranderen. De juiste werkwijze is daarom cyclisch: meten, prioriteren, verbeteren, testen en opnieuw volgen in echte gebruikersdata.

  • Vandaag: exporteer Search Console-data en bepaal welke mobiele URL-groepen de grootste achterstand hebben.
  • Deze week: koppel LCP, INP en CLS aan templates, apparaten en bedrijfs-KPI”s.
  • Daarna: kies één LCP-, één INP- en één CLS-oorzaak met een duidelijke eigenaar.
  • Voor de release: voer labtests en interactietests uit op kritieke gebruikersflows.
  • Na de release: controleer RUM-data, conversie en regressies gedurende meerdere weken.

De grootste winst ontstaat wanneer product owners, marketeers en ontwikkelaars dezelfde meettaal gebruiken. Marketing ziet welke campagnes zware scripts toevoegen, development begrijpt welke pagina”s omzetkritisch zijn en product kan prestaties meenemen in de definitie van kwaliteit. Kort gezegd, maak webprestaties zichtbaar in planning en dashboards. Zo worden snellere laadtijden, betere reactiesnelheid en stabiele pagina”s geen technisch bijproject, maar een vast onderdeel van digitale groei.
Medewerkster bekijkt een geel document in een modern kantoor

Generatieve AI op kantoor: zo automatiseer je documenten zonder kwaliteitsverlies

Waarom generatieve AI een stagiair is en geen magische vervanger

Generatieve AI kan documenten samenvatten, gegevens structureren en eerste versies van rapportages opstellen. Dat maakt de technologie aantrekkelijk voor kantoorteams met grote documentstromen. Toch ontstaat kwaliteitsverlies zodra organisaties AI behandelen als een foutloze vervanger van ervaren medewerkers.

Een betere vergelijking is die met een leergierige junior-assistent. Zo”n assistent werkt snel, verwerkt veel informatie en neemt repetitieve taken uit handen, maar heeft duidelijke instructies en controle nodig. Voor organisaties die pragmatische kantooroplossingen zoeken, betekent dit dat automatisering pas waardevol wordt wanneer processen, verantwoordelijkheden en controlemomenten vooraf zijn vastgelegd.

De kern is human-in-the-loop: een medewerker blijft betrokken op de momenten waarop interpretatie, juridische betekenis, financiële impact of reputatie een rol speelt. AI mag een concept maken, een veld invullen of een afwijking signaleren. De organisatie bepaalt vervolgens wie controleert, welke bron leidend is en wanneer een document mag worden verzonden.

  • Laat AI vooral structureren, samenvatten en formatteren.
  • Laat medewerkers feiten, bronnen, cijfers en uitzonderingen controleren.
  • Beperk automatische publicatie tot processen met een laag risico.
  • Leg invoer, output, correcties en goedkeuringen controleerbaar vast.
Team werkt samen aan laptops met code en documenten op tafel
Een duidelijke taakverdeling tussen mens en AI maakt automatisering beheersbaar en versterkt de kwaliteit van het eindresultaat.

De reële risico’s van blind vertrouwen op AI in zakelijke documenten

Het grootste risico is niet dat AI altijd onzin produceert. Het probleem is juist dat de tekst vaak overtuigend klinkt. Een taalmodel kan een nette juridische onderbouwing schrijven, een financieel cijfer logisch toelichten of een samenvatting produceren die precies aansluit op de vraag, terwijl een bronverwijzing, datum of belangrijke nuance niet klopt.

In juridische processen zijn daar duidelijke voorbeelden van. Recente incidenten met verzonnen jurisprudentie leidden tot waarschuwingen aan advocaten. De betrokken professionals gebruikten AI voor processtukken, maar controleerden niet of aangehaalde uitspraken bestonden of relevant waren. Dat kan leiden tot reputatieschade, extra kosten en verlies van vertrouwen in een dossier.

Ook financiële informatie vraagt om terughoudendheid. Een benchmark voor financiële zoekopdrachten liet zien dat algemene chatbots moeite kunnen hebben met periodes, afrondingen, boekjaren en de precieze betekenis van een vraag. In de beschreven test behaalde de best presterende ongebonden chatbot 63,8 procent exacte nauwkeurigheid, terwijl een systeem met gespecialiseerde financiële retrieval 94,2 procent bereikte. De financiële retrieval-benchmark laat daarmee vooral zien dat bronkoppeling belangrijker is dan een zelfverzekerde formulering.

  • Bronfout: een niet-bestaande, verouderde of verkeerd geïnterpreteerde bron wordt opgenomen.
  • Contextfout: een uitzondering of voorwaarde uit het oorspronkelijke document verdwijnt.
  • Cijferfout: perioden, eenheden, decimalen of valuta worden verwisseld.
  • Dossiervervuiling: een foutieve samenvatting wordt later als feitelijke bron hergebruikt.

Hallucinaties sluipen vaak stapsgewijs een organisatie binnen. Een fout in een eerste samenvatting belandt in een intern memo, dat vervolgens de basis vormt voor een klantbrief of managementrapportage. Zonder versiebeheer en bronverwijzingen wordt het later moeilijk om vast te stellen waar de fout is ontstaan. Daarom moet iedere AI-uitvoer worden behandeld als een voorstel, niet als een vaststaand feit.

Routinetaken delegeren met een heldere taakverdeling

AI is het meest geschikt voor taken met een herkenbaar patroon, duidelijke invoer en een controleerbare uitkomst. Denk aan het samenvatten van vergaderverslagen, het rubriceren van inkomende documenten, het omzetten van vrije tekst naar vaste velden en het toepassen van een huisstijl. Ook het voorbereiden van KPI-overzichten, werkvoorraadsamenvattingen en klantcorrespondentie kan tijd besparen, zolang een medewerker de inhoud controleert.

In back-office processen werken verschillende systemen, documenttypen en regels vaak naast elkaar. Een goed ingerichte workflow kan documenten classificeren, relevante informatie extraheren en ontbrekende velden signaleren. AI-workflows kunnen daarbij meerdere gespecialiseerde stappen combineren, zoals classificatie, extractie en menselijke goedkeuring. Dat is iets anders dan één chatvenster gebruiken zonder bronkader of autorisaties.

Geschikt voor AI met controle Voorbehouden aan ervaren medewerkers
Documenten sorteren op type Juridische strategie en interpretatie
Samenvattingen maken van lange dossiers Definitieve contractgoedkeuring
Velden extraheren uit facturen Besluiten over aansprakelijkheid
Opmaak en standaardteksten toepassen Financiële rapportages met hoge impact
Ontbrekende informatie signaleren Uitzonderingen, escalaties en sancties

De taakverdeling moet niet alleen beschrijven wat AI mag doen, maar ook wat AI niet mag doen. Een model kan bijvoorbeeld een contractclausule markeren, maar niet zelfstandig bepalen of een afwijking acceptabel is. Het kan een conceptantwoord schrijven, maar niet zonder goedkeuring een toezegging doen met financiële of juridische gevolgen.

Zo richt je een waterdicht validatieprotocol in

Een validatieprotocol voorkomt dat controle afhankelijk wordt van individuele oplettendheid. Het beschrijft vooraf welke bronnen mogen worden gebruikt, welke velden verplicht zijn, welke afwijkingen menselijke beoordeling vereisen en wie de eindverantwoordelijkheid draagt. IBM benadrukt bij LLM-evaluatie het verschil tussen modelkwaliteit en systeemprestaties. Niet alleen de tekst moet worden getest, maar ook data, koppelingen, beveiliging, schaalbaarheid en de uiteindelijke workflow.

  1. Beperk de invoerdata. Werk met goedgekeurde documenten, vaste templates en gestructureerde velden. Geef het model geen onnodige toegang tot complete mappen of ongeschoonde databronnen. Gebruik bij voorkeur retrieval, waarbij relevante passages uit een gecontroleerde kennisbron worden opgehaald. Leg vast welke bronversie leidend is.
  2. Voer een vierogencontrole uit. Laat een tweede medewerker kerncijfers, namen, datums, bronverwijzingen en conclusies controleren. De controleur moet niet alleen lezen of de tekst logisch klinkt, maar teruggaan naar het originele document. Bij financiële of juridische documenten hoort deze stap verplicht te zijn.
  3. Gebruik een vaste reviewmatrix. Beoordeel ieder document op volledigheid, feitelijke juistheid, bronkwaliteit, privacy, toon en autorisatie. Geef per onderdeel een akkoord, correctie of escalatie. Een document mag alleen worden gepubliceerd wanneer alle kritieke velden zijn goedgekeurd.
  4. Monitor en verbeter continu. Verzamel fouten, correcties en afwijzingen in een feedbacklog. Analyseer terugkerende patronen en pas prompts, templates, bronselectie of modelinstellingen aan. Een productieproces is pas volwassen wanneer het ook leert van uitzonderingen.

Een praktische architectuur kan verschillende gespecialiseerde controles combineren. Onderzoek naar een documentverwerkingspipeline met classificatie, splitsing, parsing, extractie en validatie laat zien hoe menselijke controle selectief kan worden ingezet op risicovolle of onzekere gevallen. De beschreven aanpak rapporteert in een productieanalyse een hoge automatiseringsgraad, maar benadrukt tegelijk de rol van menselijke validatie voor nauwkeurigheid.

Laat AI ook altijd onzekerheid tonen. Een lage zekerheidsscore, ontbrekende bron of afwijking van een verwacht patroon moet automatisch leiden tot menselijke beoordeling. De mens controleert daarbij niet alleen de inhoud, maar ook de bevoegdheid om een actie uit te voeren. Dat sluit aan bij het uitgangspunt van het human-in-the-loop-kader van de IETF, waarin aanbevelingen worden gevalideerd, geaudit en pas daarna gecontroleerd uitgevoerd.

Checklist en KPI’s om kwaliteitsbehoud meetbaar te maken

Automatisering zonder meting blijft een aanname. Registreer daarom de prestaties van het proces vóór de invoering van AI en vergelijk die met de resultaten na de pilot. Meet niet alleen snelheid. Een proces dat 40 procent sneller werkt maar twee keer zoveel correctierondes oplevert, is geen echte verbetering.

  • Foutenpercentage: aantal inhoudelijke fouten per 100 pagina”s of documenten.
  • Revisietijd: gemiddelde tijd die een medewerker nodig heeft om AI-output goed te keuren.
  • Bronvolledigheid: percentage belangrijke claims met een controleerbare bron.
  • Automatiseringsgraad: aandeel documenten dat zonder volledige handmatige verwerking doorstroomt.
  • Escalatiepercentage: aandeel documenten dat door onzekerheid of afwijkingen naar een specialist gaat.
  • Doorlooptijd: tijd tussen ontvangst van het document en definitieve publicatie.

Gebruik voor kritieke processen een nulmeting en een vaste evaluatieperiode, bijvoorbeeld vier weken. Vergelijk daarna de tijdwinst met het aantal correcties, klachten en escalaties. Evaluatie van taalmodellen kan volgens IBM bestaan uit geautomatiseerde benchmarks, menselijke beoordeling en beoordeling op systeemniveau. Kies per proces de meetmethode die past bij het risico.

Voor iedere publicatie hoort een korte checklist beschikbaar te zijn. Controleer of de juiste bronversie is gebruikt, of alle cijfers overeenkomen met het origineel, of namen en data correct zijn, of gevoelige gegevens volgens beleid zijn verwerkt en of de bevoegde medewerker heeft goedgekeurd. Leg ook vast of AI is gebruikt wanneer wetgeving, contractuele afspraken of interne governance dat vereisen.

Bouw vandaag aan een verantwoorde en efficiënte kantoorworkflow

Generatieve AI versterkt vakkennis wanneer de taakverdeling helder is. Laat de technologie snelheid en structuur leveren, terwijl medewerkers betekenis, risico en verantwoordelijkheid bewaken. Kort gezegd, AI kan uitstekend een eerste versie maken, maar de organisatie blijft eigenaar van het eindresultaat.

Start met één afgebakend proces, bijvoorbeeld het samenvatten van interne dossiers of het extraheren van factuurgegevens. Stel vooraf een bronset, reviewmatrix en KPI”s vast. Evalueer na enkele weken de tijdwinst, foutpercentages en correctierondes. Werkt het proces aantoonbaar beter, dan kan het gecontroleerd worden uitgebreid. Zo wordt AI geen onvoorspelbare vervanger, maar een schaalbare junior-assistent binnen een workflow die aantoonbaar onder controle blijft.

Wit databasepictogram op een donkerblauwe abstracte achtergrond

Vervuilde data opschonen zonder dure software: zo pak je het aan

De stille kosten van vervuilde data binnen het MKB

Vervuilde data lijkt vaak op een klein administratief probleem, totdat een verkoopkans naar het verkeerde e-mailadres gaat, een klant meerdere keren wordt gebeld of een rapportage verschillende uitkomsten laat zien. Inconsistente records, ontbrekende velden en verouderde contactgegevens zorgen dagelijks voor frictie in verkoop, klantenservice en operations.

Een groot softwarepakket lost dat niet automatisch op. Enterprise-oplossingen zijn vaak duur, vragen specialistische inrichting en kunnen bestaande onduidelijke processen zelfs verhullen. Vervuilde data opschonen zonder dure software begint daarom met heldere definities, een afgebakende dataset en afspraken over wie gegevens invoert, controleert en onderhoudt.

Kort gezegd, datahygiëne is vooral een procesdiscipline. Met spreadsheets, eenvoudige controles, OpenRefine en enkele SQL-queries kan een middelgroot team al veel bereiken, zolang iedere opschoonactie wordt gevolgd door betere invoerregels.

De meest voorkomende dataproblemen in kaart gebracht

De eerste stap is zichtbaar maken waar de kwaliteit tekortschiet. In een CRM kunnen dezelfde organisatie en contactpersoon bijvoorbeeld meerdere keren voorkomen door kleine verschillen in schrijfwijze. Denk aan “Van Dijk B.V.”, “Van Dijk BV” en “Van Dijk” als drie afzonderlijke records. Ook komen afkortingen, hoofdlettergebruik en verschillende landcodes vaak door elkaar voor.

Andere veelvoorkomende problemen zijn lege telefoonnummers, ongeldige e-mailadressen, oude functietitels en ontbrekende verantwoordelijken. Een record kan technisch compleet lijken, maar toch niet bruikbaar zijn omdat de postcode verkeerd is, de klantstatus niet klopt of de laatste contactdatum maanden achterloopt. Goede data is niet alleen correct, maar ook volledig, consistent, relevant en actueel.

De gevolgen lopen verder dan een rommelige database. Onjuiste waarden verstoren dashboards, mislukken bij integraties en maken forecasting minder betrouwbaar. Wanneer systemen records niet goed aan elkaar kunnen koppelen, ontstaan mislukte synchronisaties, handmatige herstelacties en extra werk voor medewerkers.

Analist bekijkt grafieken en dashboards op meerdere computerschermen
Een nulmeting maakt zichtbaar waar fouten de grootste bedrijfsimpact hebben en welke controles als eerste nodig zijn.
  • Dubbele records vervuilen klantbeelden en kunnen leiden tot dubbele communicatie.
  • Ontbrekende velden maken segmentatie, opvolging en rapportage onbetrouwbaar.
  • Verschillende formats veroorzaken fouten in filters, imports en koppelingen.
  • Verouderde gegevens leiden tot mislukte campagnes en gemiste contactmomenten.
  • Onjuiste autorisaties vergroten het risico dat persoonsgegevens bij de verkeerde gebruiker of leverancier terechtkomen.

Dat laatste punt verdient extra aandacht. Verwaarloosde data leidt niet alleen tot administratieve ruis, maar verhoogt ook de kans op beveiligingsincidenten en boetes van toezichthouders. De Autoriteit Persoonsgegevens benadrukt dat organisaties datalekken tijdig moeten herkennen en in veel gevallen binnen 72 uur moeten melden. Een oud of verkeerd gekoppeld contactrecord kan daardoor ook een privacyrisico worden.

Zo pak je het aan met bestaande en gratis hulpmiddelen

Begin met de tools die al beschikbaar zijn. Een spreadsheetprogramma kan verrassend veel uitvoeren: dubbele waarden markeren, lege velden filteren, patronen controleren en formats standaardiseren. Gebruik afzonderlijke kolommen voor de oorspronkelijke waarde, de voorgestelde correctie en de uiteindelijke status. Zo blijft zichtbaar wat is aangepast en kan een wijziging worden teruggedraaid.

Voor grotere bestanden biedt OpenRefine meer controle. Dit gratis, open-source programma is geschikt voor het groeperen van vergelijkbare waarden, het opschonen van tekst en het uitvoeren van herhaalbare transformaties. Met clustering kunnen bijvoorbeeld schrijfvarianten van bedrijfsnamen bij elkaar worden gezet. Controle door iemand met zakelijke context blijft noodzakelijk, want een algoritme kan niet zelfstandig bepalen of twee bedrijven werkelijk dezelfde juridische entiteit zijn.

Heeft het team toegang tot een relationele database, dan kunnen eenvoudige SQL-queries snel afwijkingen zichtbaar maken. Een query kan bijvoorbeeld alle klantnummers tonen die meerdere keren voorkomen, alle records zonder e-mailadres selecteren of waarden vinden die buiten een afgesproken lijst vallen. Werk altijd op een kopie of via een tijdelijke tabel. Directe wijzigingen in productiegegevens zonder back-up en controle zijn onnodig riskant.

Hulpmiddel Praktische toepassing
Spreadsheet Duplicaten markeren, lege velden vinden en formats controleren
OpenRefine Grote bestanden clusteren, tekstvarianten normaliseren en transformaties vastleggen
SQL Inconsistenties, dubbele sleutels en ontbrekende waarden opsporen
CRM-validatieregels Verplichte velden, keuzelijsten en invoerformaten afdwingen
Auditlog en back-up Wijzigingen volgen en herstel mogelijk maken

De keuze hangt af van omvang en risico. Een bestand met enkele duizenden records kan meestal met een spreadsheet worden aangepakt. Bij complexe relaties, meerdere databronnen of persoonsgegevens is een combinatie van SQL, OpenRefine en gecontroleerde CRM-import veiliger. De tool is ondersteunend; de werkwijze bepaalt het resultaat.

Het stappenplan voor een grondige data-opschoning

Een goede opschoning begint niet met verwijderen. Eerst moet duidelijk zijn welke gegevens nodig zijn voor het proces en welke fouten de grootste bedrijfsimpact hebben. Een verkoopteam kan bijvoorbeeld prioriteit geven aan bedrijfsnaam, contactpersoon, e-mailadres, accountowner, klantstatus en laatste contactdatum. Een operations-team kijkt mogelijk eerder naar ordernummer, locatie, leverdatum en contractstatus.

Gebruik een nulmeting voordat records worden aangepast. Tel het aantal rijen, lege waarden, dubbele sleutels en waarden buiten de toegestane categorieën. Leg ook vast welke bronnen zijn gebruikt en wanneer de meting plaatsvond. Daardoor kan later objectief worden bepaald of de kwaliteit is verbeterd.

  1. Baken de dataset af. Kies één systeem, afdeling of proces. Maak een kopie en bepaal welke velden kritiek zijn. Laat proceseigenaren vastleggen wanneer een record als bruikbaar geldt.
  2. Standaardiseer formats. Spreek vaste patronen af voor postcodes, telefoonnummers, datums, landcodes en bedrijfsnamen. Gebruik bijvoorbeeld één datumformaat en één notatie voor internationale telefoonnummers.
  3. Verwijder duplicaten zorgvuldig. Zoek eerst op unieke klant- of relatienummers. Ontbreken die, combineer dan meerdere signalen, zoals bedrijfsnaam, domein, telefoonnummer en adres. Markeer twijfelgevallen voor handmatige beoordeling.
  4. Voeg gerelateerde records samen. Bepaal welk record leidend is en welke informatie moet worden overgenomen. Bewaar de bron en leg vast waarom een record is samengevoegd, gearchiveerd of verwijderd.
  5. Bouw validatie aan de bron in. Maak kritieke velden verplicht, gebruik keuzelijsten en beperk vrije tekst waar dat niet nodig is. Voeg controles toe voor e-mailadressen, datums en dubbele klantnummers.

Standaardisatie moet aansluiten op het gebruiksdoel. Een telefoonnummer kan voor bellen anders worden opgeslagen dan voor een externe integratie. De juiste norm is daarom niet de meest uniforme waarde op papier, maar de waarde die in alle betrokken processen betrouwbaar werkt.

Betrek medewerkers die dagelijks met de gegevens werken. Zij herkennen uitzonderingen die in een technische controle niet zichtbaar zijn, zoals dochterondernemingen met dezelfde hoofdnaam of klanten die onder verschillende handelsnamen bestellen. Datakwaliteit is immers afhankelijk van de context waarin gegevens worden gebruikt, niet alleen van de structuur van een tabel.

KPIs om te volgen en veelvoorkomende valkuilen

Na de eerste opschoning begint het onderhoud. Kies een klein aantal KPI”s die direct aansluiten op het doel. Een verkoopteam wil vooral weten hoeveel actieve accounts complete contactgegevens hebben. Een CRM-beheerder kijkt eerder naar dubbele records, foutmeldingen en records die te lang niet zijn bijgewerkt.

  • Foutpercentage per batch: het aandeel records dat een controle niet doorstaat.
  • Percentage dubbele records: het aantal duplicaten ten opzichte van het totale aantal records.
  • Compleetheid van kritieke velden: het percentage records met alle verplichte waarden.
  • Actualiteit: het aandeel records dat binnen de afgesproken termijn is gecontroleerd of bijgewerkt.
  • First-time-right: het percentage nieuwe records dat direct correct wordt ingevoerd.
  • Aantal herstelacties: hoe vaak teams handmatig fouten in integraties of rapportages moeten corrigeren.

Maak onderscheid tussen proces-KPI”s en ondersteunende metrics. Een KPI stuurt een beslissing, bijvoorbeeld de doelstelling om dubbele records onder 1 procent te houden. Een metric geeft context, zoals het aantal duplicaten per invoerkanaal of per team. Dit onderscheid voorkomt dashboards met tientallen cijfers waar niemand actie aan koppelt.

Een veelgemaakte fout is een eenmalige schoonmaakactie zonder nieuw invoerbeleid. De database ziet er enkele weken beter uit, maar dezelfde fouten keren terug zodra medewerkers vrije tekst blijven gebruiken, imports geen controles hebben of meerdere systemen zonder eigenaar gegevens wijzigen. Ook te agressief opschonen is riskant. Verwijder niet automatisch records die op elkaar lijken, maar gebruik een quarantaine- of beoordelingslijst voor twijfelgevallen.

Plan daarom een vast ritme. Wekelijks kunnen nieuwe records en foutmeldingen worden gecontroleerd. Maandelijks is een bredere analyse passend, met aandacht voor duplicaten, volledigheid en actualiteit. Archiveer verouderde records volgens een gedocumenteerd beleid, rekening houdend met bewaartermijnen en de AVG.

Zet vandaag de eerste stap naar betrouwbare bedrijfsdata

Een MKB-team hoeft niet te wachten op een grote softwaremigratie om de datakwaliteit te verbeteren. Begin met één dataset die zichtbaar belangrijk is voor omzet, service of rapportage. Maak een kopie, voer een nulmeting uit en laat een data-eigenaar bepalen welke velden als kritiek gelden.

  • Tel dubbele records en ontbrekende waarden.
  • Noteer de drie meest voorkomende invoerfouten.
  • Kies vaste formats voor datums, telefoonnummers en postcodes.
  • Corrigeer eerst de records met de grootste bedrijfsimpact.
  • Stel verplichte velden en keuzelijsten in.
  • Plan een wekelijkse controle en een maandelijkse kwaliteitsmeting.

Wat levert het op? Minder handmatig herstelwerk, betrouwbaardere rapportages, betere klantopvolging en een kleiner risico dat persoonsgegevens verkeerd worden gebruikt. Kleine, gestructureerde stappen leveren op termijn vaak meer rendement op dan een dure migratie die onduidelijke processen naar een nieuw systeem verplaatst.

Onderwerp het eigen databestand vandaag aan een nulmeting. Niet om iedere afwijking direct op te lossen, maar om de grootste bron van ruis te vinden. Kies daarna één concrete verbetering, wijs een eigenaar aan en meet na dertig dagen opnieuw. Zo wordt datahygiëne geen tijdelijk project, maar een beheersbaar onderdeel van de bedrijfsvoering.